Cosmos3 学习与实践
这篇记录整理了 Cosmos3 的核心原理,以及我在 Astribot 上从数据适配、模型训练到部署和实机测试的过程。前期使用 Nano 打通训练与推理流程,Edge 开源后转向 Edge 训练,完成 20k checkpoint,并保存了 20 段方块分类任务录像。
训练使用修改后的 cosmos-framework。Edge 20k 在 20 次捡方块测试中平均得到 8.7/10 分;RTX 5090 端侧推理已达到 4 步采样约 680 ms。实际部署中,减少采样步数会带来动作抖动,增加到 50 步则明显更平滑,但耗时升至约 7.5 秒。因此下一阶段的重点是找到速度与动作稳定性之间合适的取舍。
官方入口:NVIDIA Cosmos · Cosmos Framework · Cosmos3 技术报告
目录
1. Cosmos3 的核心原理
1.1 模型定位与规模
Cosmos3 面向物理世界的理解、预测和交互,能够处理文本、图像、视频、音频与机器人动作。对机器人任务来说,它的特点是:根据当前观测和任务指令,同时预测未来动作与未来画面,将动作学习和环境变化联系起来。
| 模型 | 总参数量 | 单塔骨架规模 | 本项目中的用途 |
|---|---|---|---|
| Cosmos3-Edge | 约 4B | 约 2B | 后期训练与实机测试 |
| Cosmos3-Nano | 约 16B | 约 8B | 数据适配、训练和部署验证 |
| Cosmos3-Super | 约 64B | 约 32B | 技术调研 |
模型包含两套 Transformer 参数,因此总参数量与单塔骨架规模不同。通用模型、DROID 专用策略和本地 Astribot 微调模型也有各自的用途;在 Astribot 上使用时,仍需适配相机、状态和动作接口。
1.2 MoT:理解与生成怎样协作
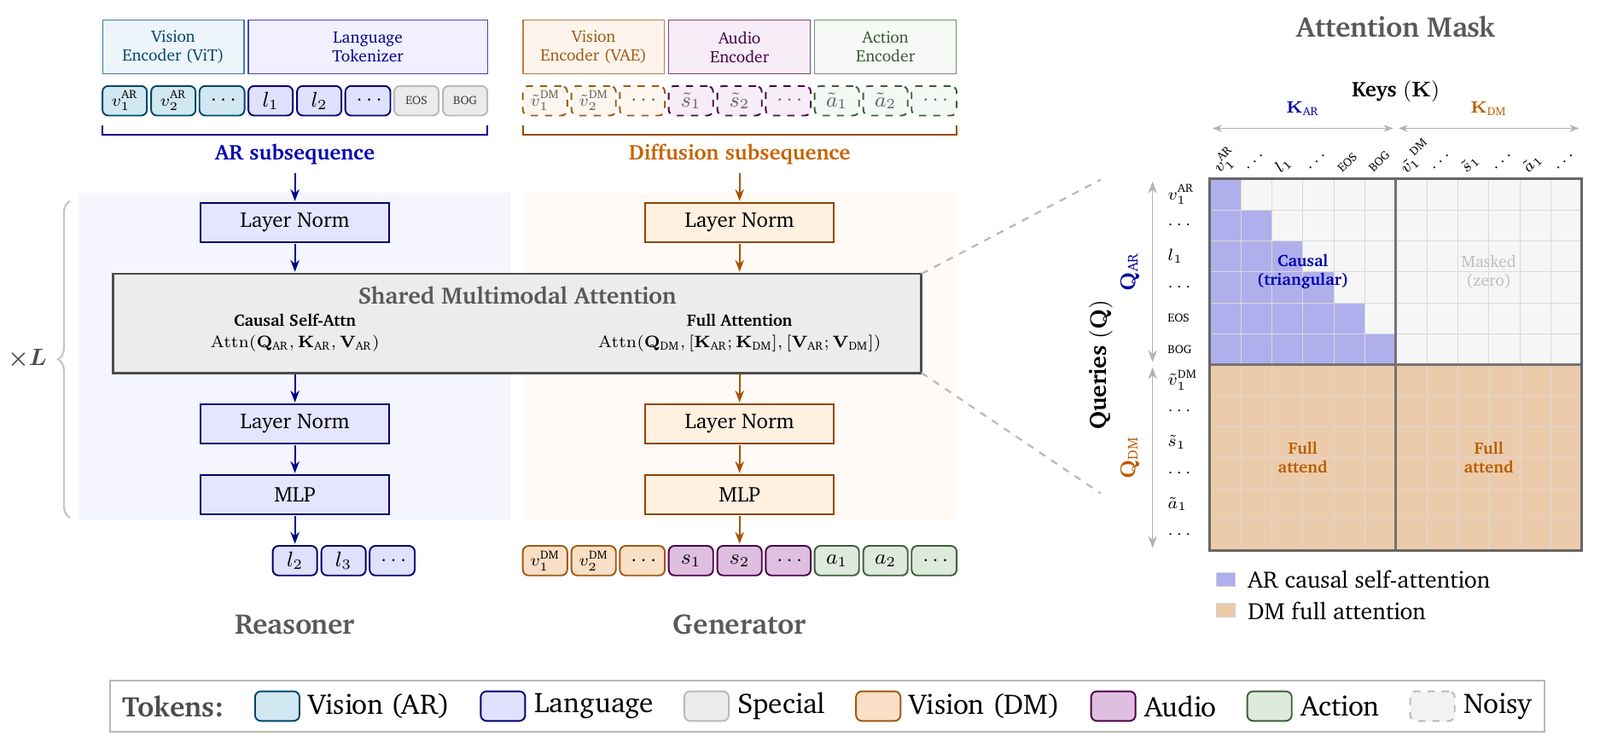
技术报告 Figure 5,p.11。左侧是理解与生成两条计算路径,右侧展示它们能读取的 token 范围。
Cosmos3 采用 Mixture-of-Transformers(MoT)结构,包含两个相互配合的部分:
- Reasoner 使用自回归方式处理理解侧的文本和视觉信息,生成描述、推理或结构化答案。
- Generator 通过流匹配生成连续信号,包括视频 latent、音频 latent 和机器人动作。
两者在每层保留独立参数。Generator 可以读取 Reasoner 的上下文,以及正在去噪的生成序列;Reasoner 使用因果注意力,不读取加噪的生成 token。这样既保留语言理解能力,也能处理视频和动作的连续生成。
视觉输入有两条路径:理解任务通过 ViT 提取语义,生成任务通过视频 VAE 编码。Cosmos3 使用的 Wan2.2 VAE 在时间上压缩 4 倍、空间上压缩 16×16,后续 patch 合并再将主干中的空间尺度降至原图的 1/32。
1.3 世界预测与动作生成
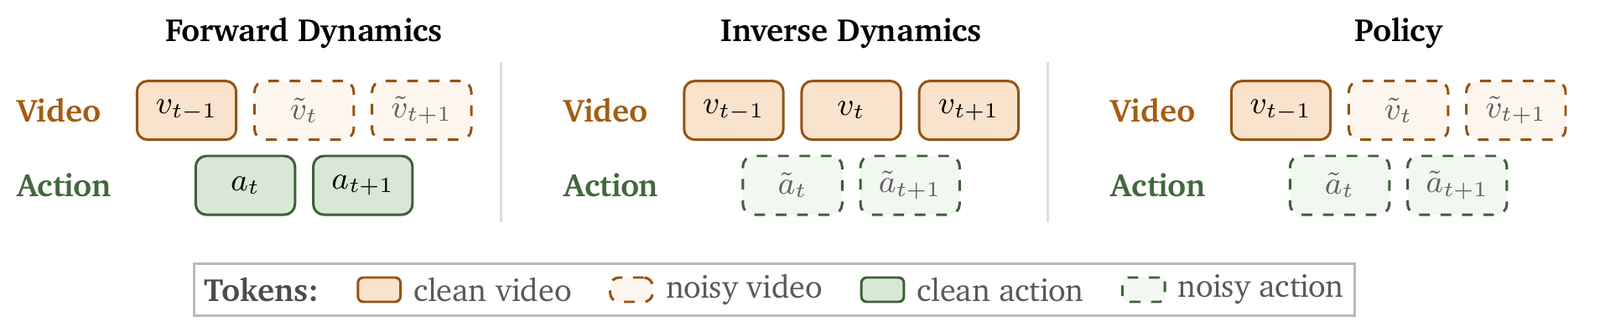
技术报告 Figure 4,p.10。实线表示已知条件,虚线表示加噪后需要生成的目标;Policy 同时生成未来视频与动作。
通过改变条件和预测目标,模型可以承担三类任务:
| 模式 | 已知条件 | 预测内容 |
|---|---|---|
| 前向动力学 FD | 当前观测、给定动作 | 执行动作后的未来视频 |
| 逆动力学 ID | 一段观测变化 | 对应的动作 |
| 策略 Policy | 当前观测、本体状态、任务指令 | 未来动作与视频 |
本项目主要使用 Policy。训练时,当前画面与状态作为条件,未来视频和动作加入噪声,模型学习如何逐步恢复它们。用流匹配的一种时间约定表示:
\[ x_t=(1-t)x_0+t\epsilon,\qquad v^*=\epsilon-x_0. \]
其中 \(x_0\) 是真实数据,\(\epsilon\) 是噪声。模型预测速度场,推理时从噪声出发逐步得到视频与动作。联合训练让模型同时学习“应该怎么动”和“动完以后会发生什么”,代价是推理时也需要处理视觉 token。
1.4 从通用模型到机器人策略
生成侧训练大致经过三个阶段:先从大规模多模态数据中学习外观和运动规律,再加入动作数据进行 FD、ID、Policy 中期训练,最后针对具体机器人和任务微调。
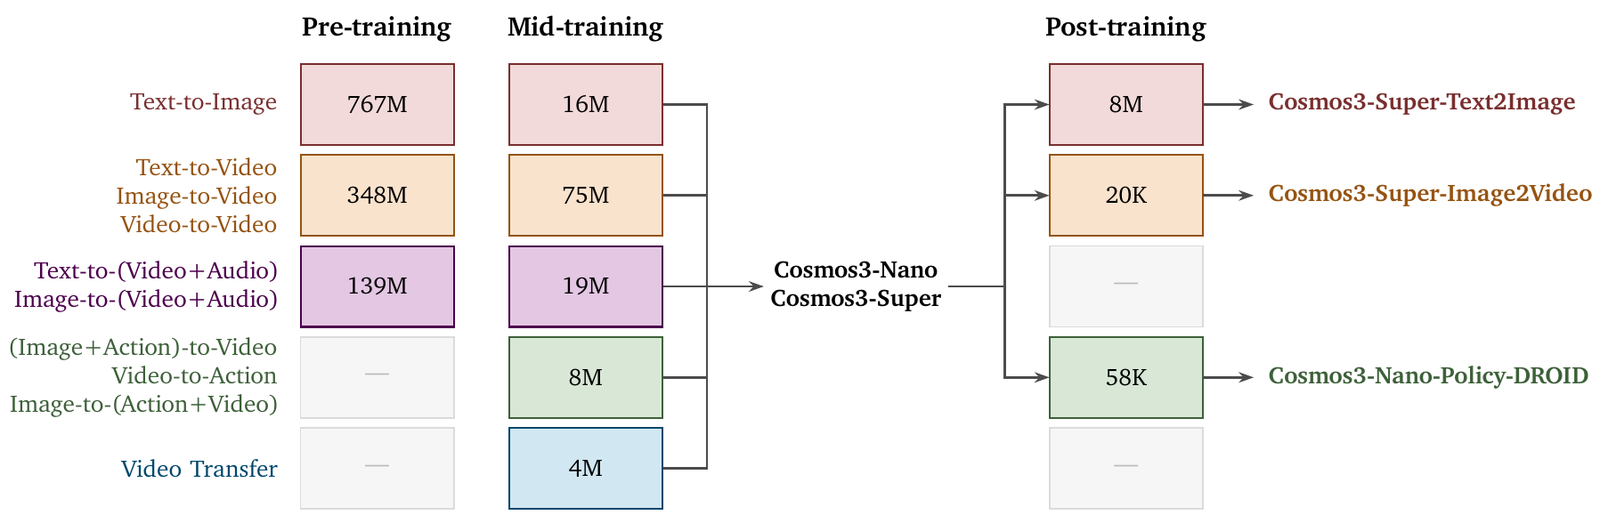
技术报告 Figure 8,p.20。动作数据在中期训练加入,再由共享基座派生出机器人 Policy 等专用模型。
官方 Nano-Policy-DROID 使用 8 维关节与夹爪动作,预测未来 32 步。适配新机器人时,需要重新处理动作编码、解码、模态 embedding,以及对应的数据分布。Astribot 的 25 维接口便是在这一步接入的。
2. Astribot 数据与模型适配
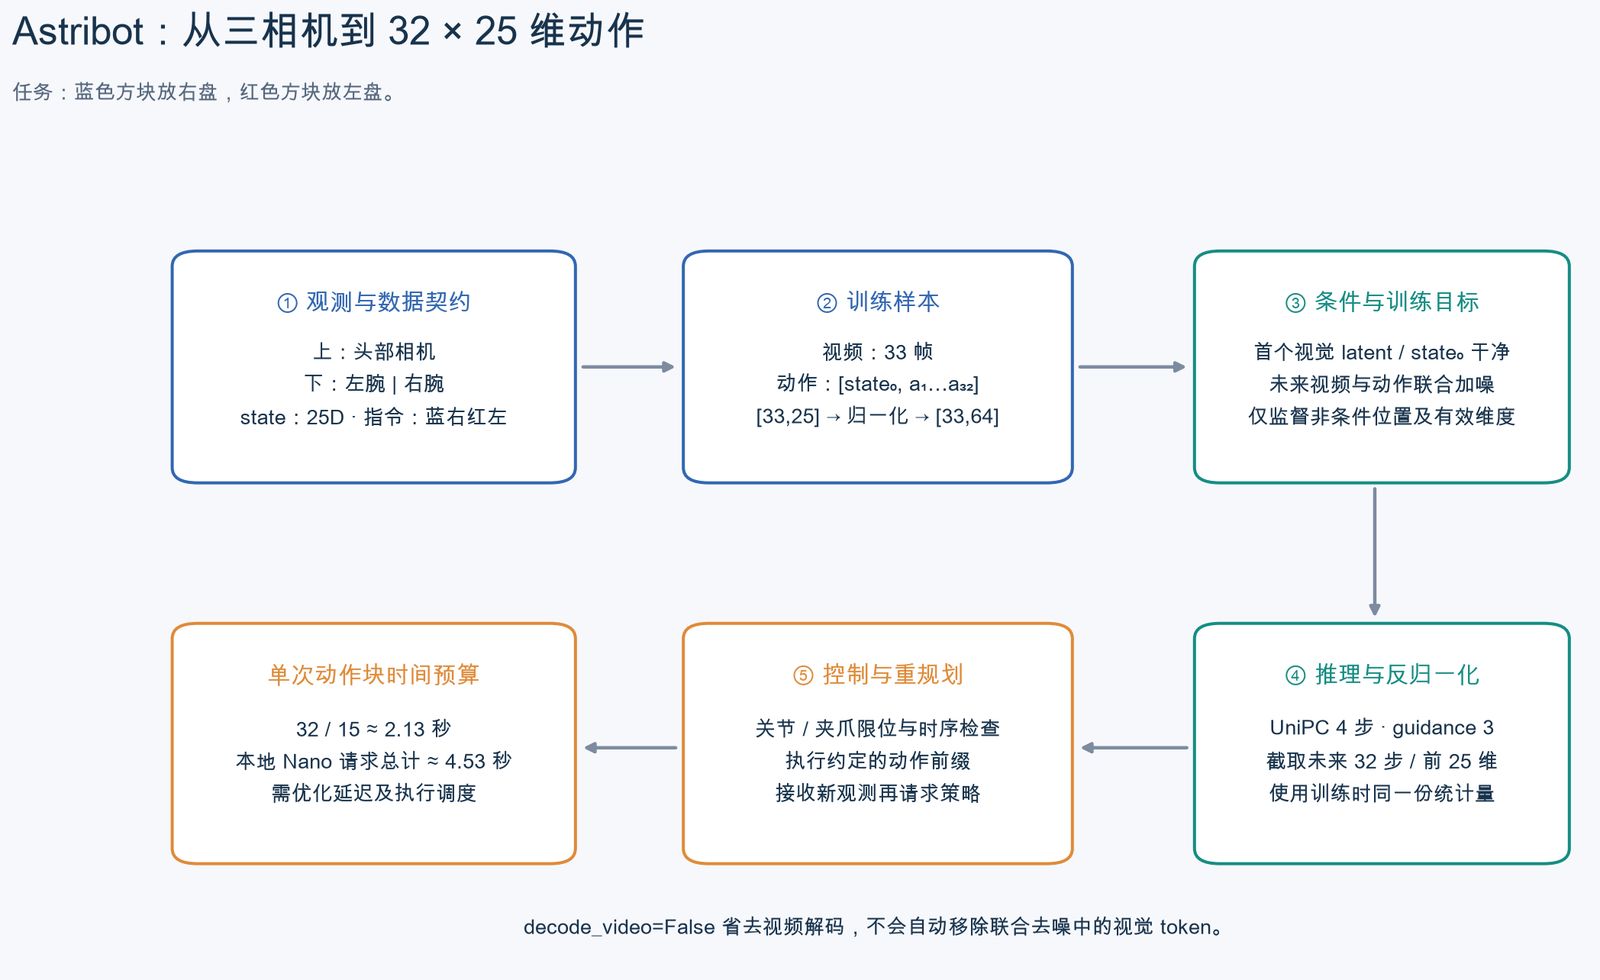
任务是将桌面上的蓝色方块放入右盘,红色方块放入左盘。输入包括头部、左腕、右腕三路相机、当前机器人状态和任务指令,输出为未来 32 步的 25 维动作。
2.1 三相机与时序组织
相机拼图固定为头部视角在上、左腕和右腕视角在下。训练和部署使用相同的布局、缩放方式与颜色通道顺序。
| 数据 | 组织方式 |
|---|---|
| 视频 | 33 帧:当前帧 + 未来 32 帧 |
| 状态与动作 | 当前 25D state + 未来 32×25D action |
| 模型动作输入 | [33,25] 归一化后补齐为 [33,64] |
| 条件位置 | 首个视觉 latent 和动作序列中的当前 state |
| 动作监督 | 未来位置的有效 25 维,忽略补齐维度 |
| 部署输出 | 去掉条件位置、裁剪并反归一化,得到 [32,25] |
这里最容易出错的是时序对齐:动作标签究竟表示当前命令、下一时刻目标还是状态差分,需要在数据转换时确定。帧号相同不一定代表物理时刻一致,整体错一帧也会影响动作学习。
2.2 归一化与动作定义
状态和动作采用分位数归一化,用训练数据中的 q01、q99 将各维主要分布映射到约 [-1,1]:
\[ \tilde a_j=2\frac{a_j-q_{01,j}}{\max(q_{99,j}-q_{01,j},\epsilon)}-1. \]
部署时使用同一份统计量反归一化。各通道的单位和量级不同,关节、夹爪的顺序必须明确;近常量维度也要避免除零。统计量应在划分 train/val 后,仅使用训练集计算。
早期代码使用 normalizer_stats/astribot_lerobot_stats.json,后续配方使用 datasets/normalizers/astribot.json,两者 JSON 层级不同。实际复现时要与 loader 对应,不能只改文件名。曾经沿用其他任务的统计量,也是需要特别避免的问题。
2.3 具体训练哪些权重
我使用 cosmos-framework 进行机器人策略微调。这套配方主要训练生成侧主干及其视觉、动作接口,冻结 Reasoner 和视频 VAE。
| 模块 | 是否训练 | 在联合生成中的作用 |
|---|---|---|
生成侧 Transformer(moe_gen) |
训练 | 包括注意力投影、MLP 和归一化层,学习视频与动作的联合动态 |
时间步编码(time_embedder) |
训练 | 编码去噪时间步,由视频与动作分支共用 |
视觉映射(vae2llm、llm2vae) |
训练 | 将视频 latent 映射到主干,再输出视频速度场 |
动作映射(action2llm、llm2action) |
训练,5 倍基础学习率 | 按机器人类型映射动作输入和动作速度场输出 |
动作模态编码(action_modality_embed) |
训练,5 倍基础学习率 | 标识动作 token |
| Reasoner | 冻结 | 保留语言条件处理及已有理解表征 |
| Wan2.2 视频 VAE | 冻结 | 提供固定的视频编码与解码空间 |
| 理解侧 ViT | 默认不启用 | 机器人观测通过 VAE 编码 |
| 音频模块 | 不启用 | 本任务不生成音频 |
| EMA 模型 | 不参与梯度优化 | 若启用,通过训练权重的滑动平均更新 |
视觉映射层会更新,VAE 本体保持固定。 模型是在既有的视频 latent 空间中学习未来变化,无需重新训练视频编码器和解码器。
开始微调时,动作输入、输出映射和模态编码会重新初始化,再使用 5 倍基础学习率适配 Astribot。当前配方的基础学习率为 2e-4,训练过程中随学习率计划调整。
以上对应本地 Nano/Astribot 配方;Edge 20k 的完整运行配置尚未归档,其具体训练范围仍需结合对应配置确认。
2.4 动作与未来视频怎样一起学
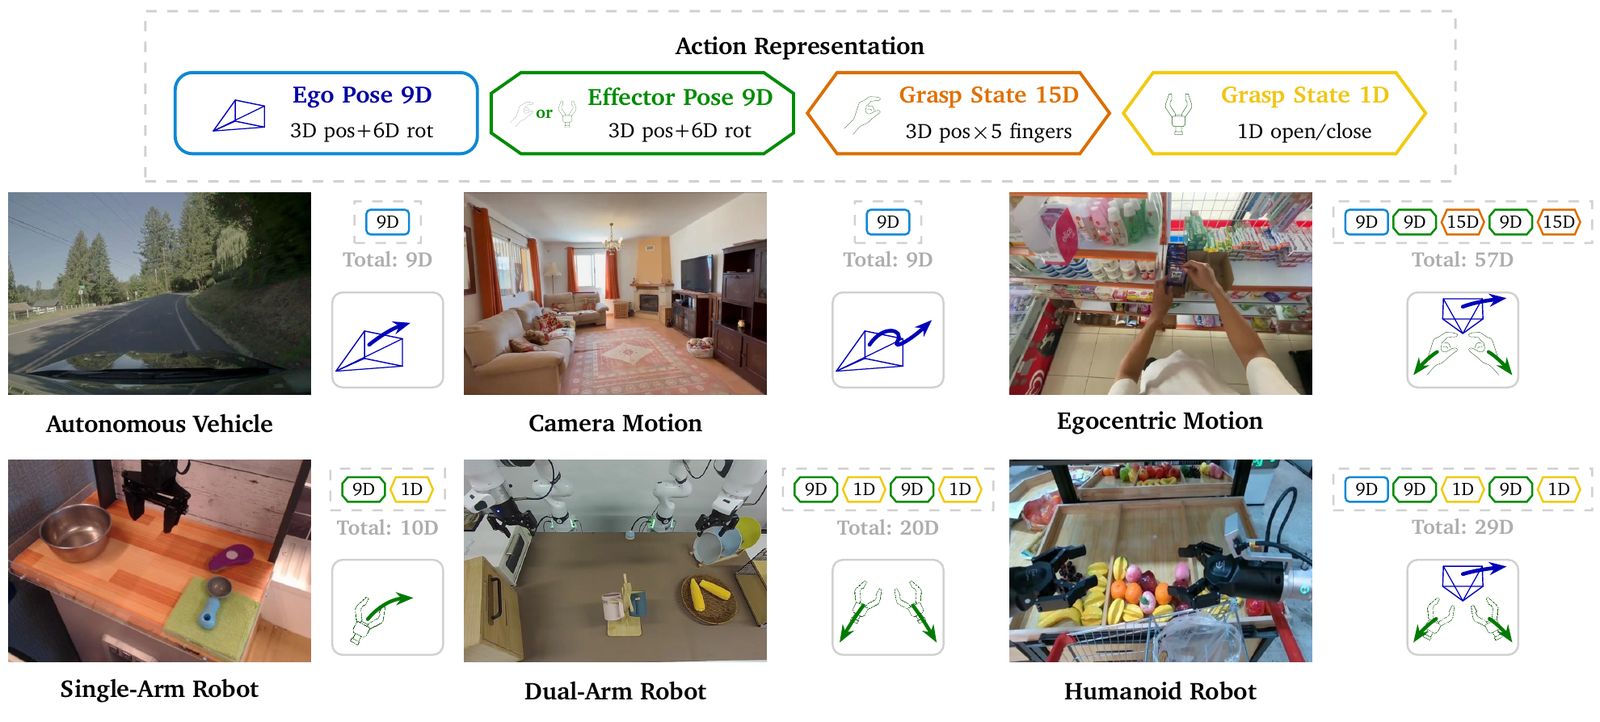
技术报告 Figure 3,p.8。不同形态保留自己的动作接口,通过 domain 专属映射进入共享主干;Astribot 在本项目中使用 25D joint 接口。
视频和动作分别进入 vae2llm 与 action2llm,在同一个 Generator 中联合处理,再由两套输出映射预测各自的速度场。因此,两种损失会共同更新生成侧主干;视觉和动作接口也会随联合目标一起适配。
当前 Astribot 视频配方可以概括为:
\[ \mathcal L = 10\,\mathcal L_{\mathrm{video}} + 10\,\mathcal L_{\mathrm{action}}. \]
条件位置不参与去噪目标,动作损失只计算有效的 25 维。两个系数相同也不代表两项损失或梯度贡献相同,训练时仍应分别观察。
这也解释了为什么训练未来视频并不需要解冻 VAE:学习发生在 latent 空间,更新的是生成主干与 latent 映射层。Joint 与 EEF 的区别则属于动作接口设计;改成 EEF 时,还需明确坐标系、旋转表示和 IK/FK 转换。
3. 我的训练记录
3.1 实验过程
前期主要使用 Nano 完成数据适配和训练部署。2026年7月20日,NVIDIA 公开发布 Cosmos3-Edge 权重,随后我将训练重心转向 Edge,继续开展捡方块任务的微调与端侧部署。官方模型卡
| 阶段 | 主要工作 |
|---|---|
| 基础验证 | 配置环境,运行 Nano action demo 和策略服务,熟悉推理流程 |
| 数据适配与部署 | 在 A100 环境接入 Astribot 数据,完成权重转换、训练、导出和 25D 服务部署 |
| Nano 训练 | Nano 保存到 step 6000,记录 loss、训练速度,并尝试降低学习率 |
| 训练配置调整 | 调整 batch、梯度累积、数据统计与 normalizer,整理复现手册 |
| Edge 训练 | Edge 完成 20,000 step 训练 |
| 实机测试 | 使用 Edge 20k 进行方块分类测试,保存 20 段实机录像 |
3.2 数据规模
数据使用 LeRobot v3 格式,由 parquet 状态/动作、相机 MP4 和 metadata 组成。一份数据统计包含 100 个 episode,其中 95 个用于训练;Edge 训练记录采用的 task01 原始帧数为 54,991。另一份训练配方统计到 50,297 个训练窗口。
有些统计脚本会把 state 和 action 合并计算分位数,因此输出的 109,982 行等于 54,991×2,并不表示数据帧数翻倍。后续比较实验时,统一使用 episode 数、原始帧数和实际训练窗口数即可。
3.3 Edge 20k 训练成本
Edge 使用 micro batch 16 × 8 卡 × 梯度累积 4,global batch 为 512。
| 项目 | 数值 |
|---|---|
| 训练步数 | 20,000 |
| 总耗时 | 12 天 4 小时,即 292 小时 |
| 全程平均每步耗时 | 52.56 秒 |
| 平均每 1000 step | 14.6 小时 |
| GPU 时数 | 约 2336 GPU·h,按 8 卡全程占用估算 |
按 20,000×512÷54,991 计算,样本暴露量约相当于原始帧数的 186.2 倍。由于训练使用时序窗口和 packing,这个值不直接等于严格的 epoch 数。
训练配置与运行记录见 W&B run。
3.4 Loss 曲线与训练时长
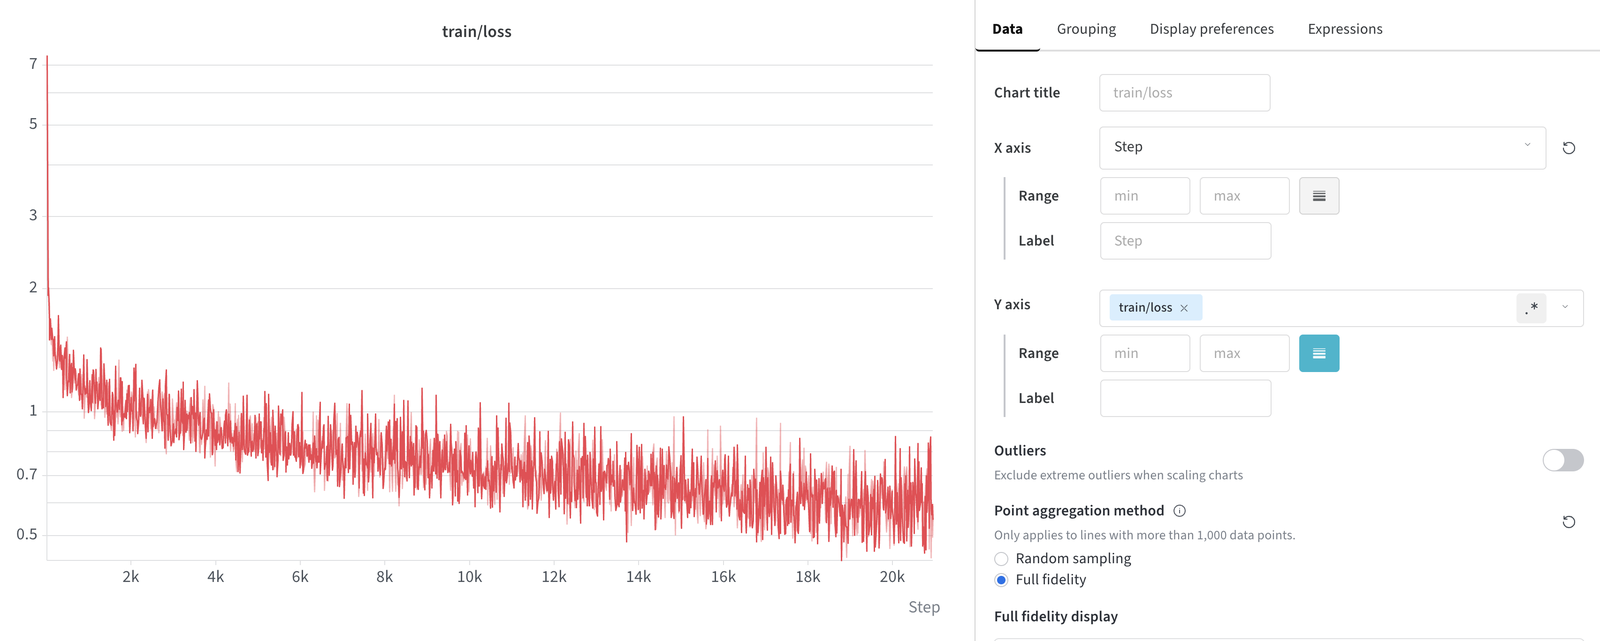
总训练 loss,截图覆盖约 21k step。以下数值均为读图约值。
总 loss 从初期的 7 以上迅速下降,约 2k 时降到 1 附近,随后逐渐降至 20k 附近的 0.6 左右。后半程仍有下降,只是速度明显放缓;单步波动较大,不能靠某一个低点选择 checkpoint。
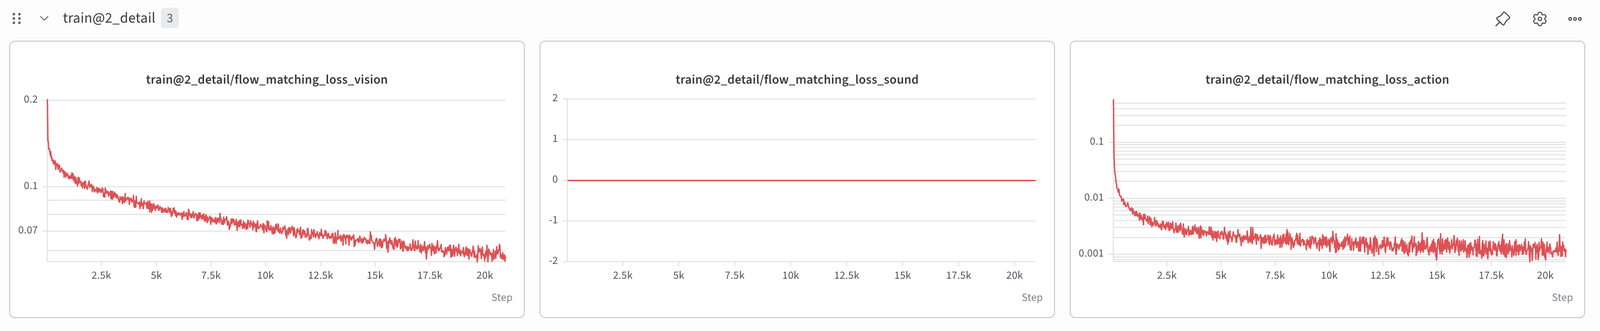
从左到右为 vision、sound、action 的 flow matching loss。动作图采用对数纵轴,后期看起来平缓,仍可能有可观的相对下降。
- 动作项前期改善最快。 前几千步已降至几千分之一;约 10k 时为 0.0015–0.002,20k 附近约为 0.001。后半程仍在学习,但这些下降能否改善抓取、分盘和动作平滑度,需要实机比较。
- 视频项持续下降。 约 5k、10k、20k 时分别为 0.08、0.07、0.055–0.06,尚未明显持平。如果目标也包括未来视频生成,应同时比较生成画面。视频项的数值明显大于动作项;若沿用前述等权配方,总 loss 会更多反映视频项的变化,但这不等于它对梯度的贡献也按同比例占优。
- 声音项始终为 0。 这与当前任务未启用声音训练相符,不能解释为声音生成已经收敛。
是否需要训练这么久?下一轮不必默认跑满 20k,但目前还不能确定最佳停止点。 现有曲线只有训练 loss,没有验证集曲线,也没有较早 checkpoint 的同条件实机成绩,无法据此判断泛化是否继续改善或是否过拟合。20k 的 8.725 分说明这个 checkpoint 可用,并不能说明达到这个水平必须训练到 20k。
下一轮从 5k 开始评测,对比 5k、10k、15k、20k,固定初始摆放、采样步数、动作执行方式和超时规则,记录任务得分、满分比例、完成时间与抖动情况。若连续两轮没有稳定提升,就优先选较早的 checkpoint;若还需要未来视频生成,则把视频质量一起纳入选择。假如 10k 与 20k 的实机表现相当,按本次平均速度估算,可节省约 146 小时,即 6 天 2 小时,约一半训练成本。
4. 训练与部署操作流程
下面保留 Nano/Astribot 的关键步骤。训练代码和 TOML 已能在本地 cosmos-framework 中查看,命令里的 /zhaodongyu/... 统一作为服务器路径示例,部署时对应实际的数据和权重目录。
4.1 准备环境和资源
先设置工程、数据与模型路径:
1 | export COSMOS_REPO=/zhaodongyu/2026/cosmos-framework-a100 |
历史环境采用 CUDA 12.8 依赖组,同时安装训练和策略服务依赖。5090 的一次安装问题来自 Python 3.14 与 cp313 wheel 不匹配,当时通过 Python 3.13.14 解决:
1 | uv python install 3.13.14 |
准备好 Nano 权重、tokenizer/config 和 Wan2.2 VAE,并确认能实际读取一段数据视频。离线模式应在资源缓存齐全后开启。
4.2 检查数据与训练样本
训练前先取一个样本,查看三相机拼图、任务指令和动作值。重点确认视频为 33 帧、动作序列为 [33,25],第 0 步来自当前 state;transform 后动作补齐为 [33,64]。
启动训练前,需要将数据目录和任务指令切换为捡方块任务。当前训练配方采用 30 FPS,历史部署记录使用 15 Hz;复现时应核对数据采样与动作执行的时间定义,并在实际生效的配置中统一设置。
同时检查 normalizer 的正反变换,并将 train/val 按 episode 划分。完成这些检查后,先运行少量 step,确认训练、保存和恢复都正常,再开始长时间训练。
4.3 转换权重并启动训练
将 HF 权重转换为训练使用的 DCP:
1 | python -m cosmos_framework.scripts.convert_model_to_dcp \ |
历史训练入口使用 action_policy_astribot_repro.toml。主要配置包括学习率、batch、token 上限、activation checkpointing 和保存间隔。token 上限对应的 override 路径是 model.config.max_num_tokens_after_packing。
1 | export ASTRIBOT_TASK_PROMPT="Put the blue block on the table into the right plate, and the red block into the left plate." |
训练时分别观察 video loss、action loss、学习率、显存和 s/iter。续训前检查 latest_checkpoint.txt,确保恢复的是预期 step,并保留相同的数据和 normalizer。
4.4 导出部署权重
以下以记录中的 6000 步 checkpoint 为例:
1 | export RUN_DIR=/zhaodongyu/outputs/train/cosmos3_action_astribot/action_sft/action_policy_astribot_repro |
模型权重、训练配置、动作定义和 normalizer 应一起保存。目录名带上 step,后续切换模型和比较结果会清楚很多。
4.5 启动服务并接入机器人
1 | export MASTER_ADDR=127.0.0.1 |
已有服务记录使用 joint position、quantile 归一化、4 步 UniPC、guidance 3 和 shift 5。客户端发送三相机图像、25D 状态及指令,服务返回 [32,25] 动作。
接入前先检查 /healthz,再用保存的观测完成一次推理,核对动作量级、夹爪方向和关节限位。历史服务出现过 transform 配置读取失败后自动回退的情况,因此启动成功后仍需确认实际使用的 transform 与训练一致。
5. 部署性能与实时性
5.1 Edge 在 RTX 5090 上的实测
以捡方块任务为例,Cosmos3-Edge 的端侧部署呈现出很直接的速度与平滑性取舍:
| 降噪采样步数 | 单次推理耗时 | 动作表现 | 适用方向 |
|---|---|---|---|
| 4 步 | 约 680 ms | 响应快,但动作有些抖动 | 低延迟闭环的优化起点 |
| 50 步 | 约 7.5 s | 动作平滑很多 | 平滑性参照、允许等待的分段执行 |
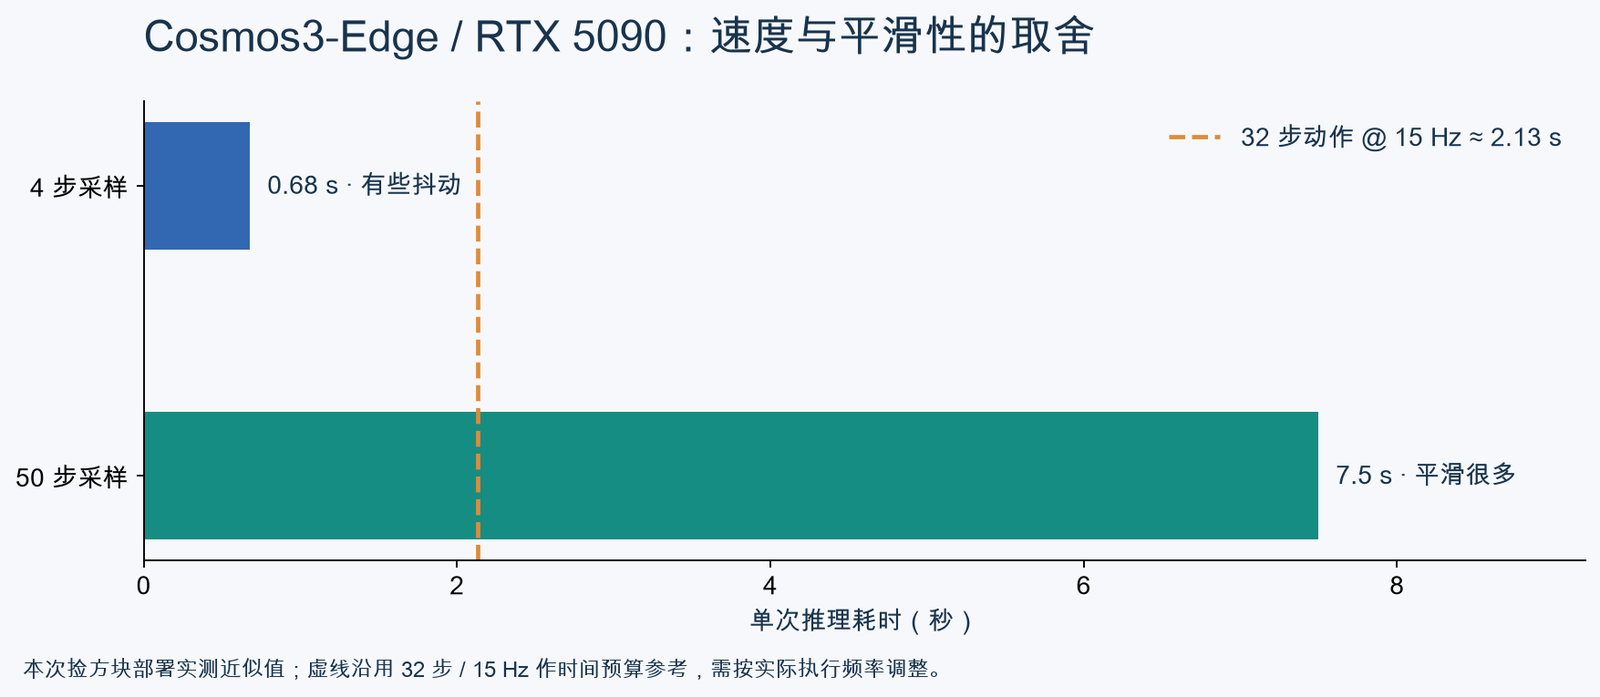
从 4 步增加到 50 步,推理耗时约增加到 11 倍。更多步数改善了这次测试中的动作平滑性,但还需要结合抓取和任务得分判断整体收益。benchmark 评分表未记录采样步数,因此不将 8.7 分归属于某一档配置。
5.2 部署怎样取舍
先在 4—50 步之间寻找满足平滑性要求的最小采样步数。 下一轮可固定 checkpoint、指令与初始摆放,依次测试 8、12、16、20 步,同时记录任务得分、动作抖动、整体完成时间和推理 p50/p95。这些中间档位尚未实测,不能按两端耗时直接认定最佳值。
如果沿用 32 步动作和 15 Hz 执行频率,一个动作块覆盖约 2.13 秒。4 步推理约占这一预算的 32%,有机会与执行重叠;50 步耗时约为预算的 3.5 倍,连续控制会明显等待。若每次只执行动作前缀,预算还会更短,例如执行 8 步只有约 0.53 秒,即使 680 ms 也可能跟不上。实际部署需按控制器频率重新计算。
在选步数之外,可以逐项尝试动作块衔接、重叠段融合、适度插值或关节速度/加速度约束,观察抖动来自单块内部还是两块交界。平滑处理会增加滞后,夹爪开合也应单独处理。异步推理可隐藏部分等待,但不能持续弥补动作产出速度低于消耗速度的问题。
当前服务通过 --num-steps 调整步数;decode_video=False 仅跳过视频解码,仍保留联合去噪中的视觉计算。
5.3 Nano / A100 的早期部署记录
一次 Nano 请求总耗时为 4532.6 ms,其中模型推理 2960.6 ms、预处理 52.4 ms、后处理 0.1 ms,另有约 1.52 秒尚未被分项计时覆盖。
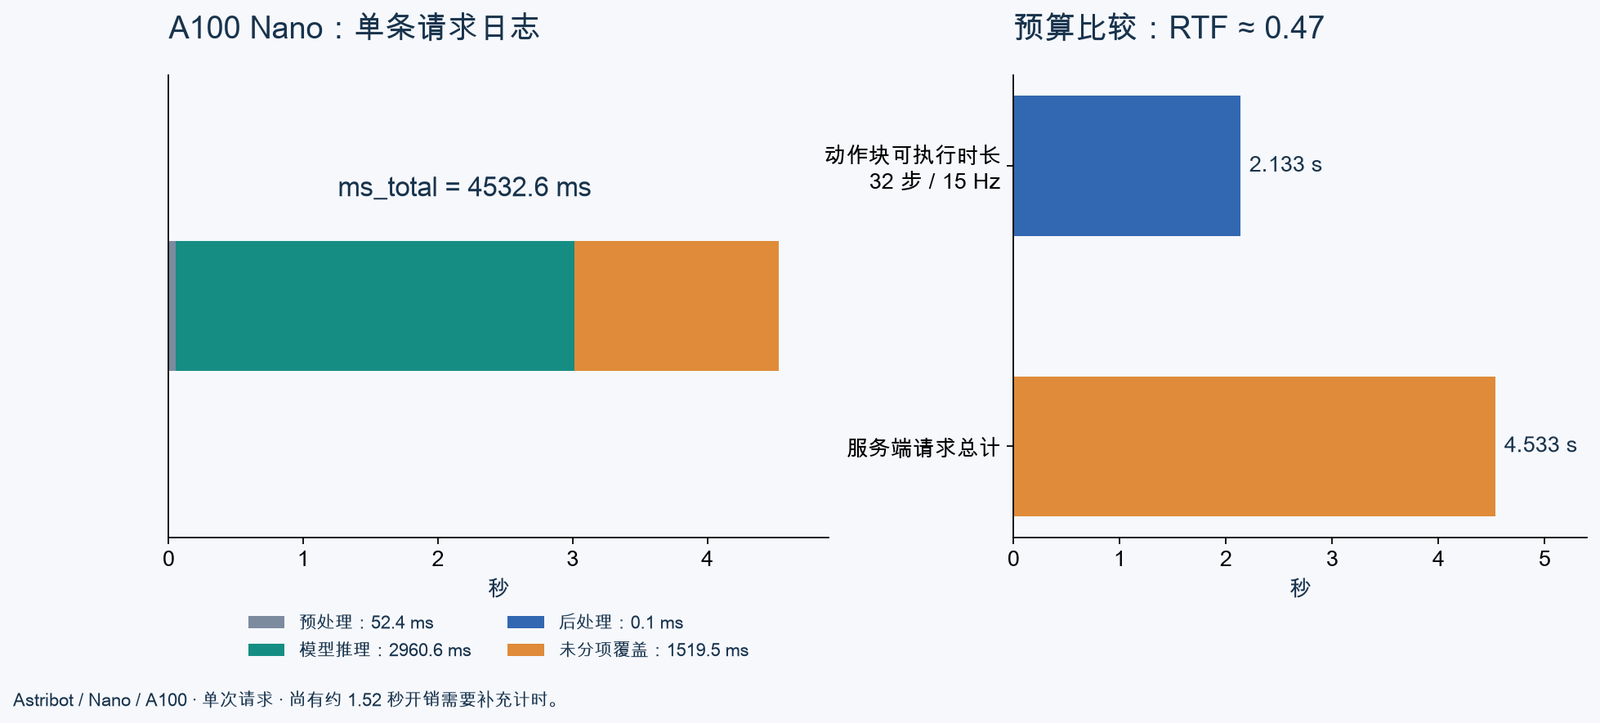
这条记录保留用于回顾早期服务瓶颈。它与后来的 Edge / 5090 属于不同模型和运行配置,不能把差距全部归因于显卡。当前部署决策应优先围绕 Edge 的端到端时延、动作稳定性和任务得分展开。
5.4 硬件算力与带宽参考
下表整理了现有的硬件参数,便于对照各平台的计算能力和带宽。
| 指标 | A100 | RTX 5090 | H20 | Thor |
|---|---|---|---|---|
| FP16 | 312 TFLOPS | 209.5 TFLOPS | 148 TFLOPS | 约 258 TFLOPS |
| FP8 / INT8 | 624 TOPS | 419 TFLOPS | 296 TFLOPS | 517 TFLOPS |
| 带宽 | 2039 GB/s | 1792 GB/s | 4000 GB/s | 273 GB/s |
实际部署还要结合使用精度、稀疏计算设置、显存容量和端到端耗时。对捡方块任务而言,最终仍以动作质量和完成效率来选择配置。
6. 捡方块实机测试与模型对比
测试使用 2 红 2 蓝四个方块,目标为蓝块进右盘、红块进左盘,共 20 种初始摆放。评分说明为正确完成一块计 2.5 分,满分 10 分;超时则按已完成情况计分。
Benchmark 捡方块结果记录共包含以下 6 组配置。均值由各组 20 次得分重新计算,满分比例按得分为 10 分的次数统计。
| 模型 | 训练记录 | 精度 | 平均得分 / 10 | 满分次数 | 满分比例 |
|---|---|---|---|---|---|
| pi0 | 50k step,29 epoch | FP32 | 6.600 | 7 / 20 | 35% |
| pi0 | 100k step | FP32 | 5.700 | 6 / 20 | 30% |
| pi0 | 100k step | BF16 | 5.325 | 7 / 20 | 35% |
| Cosmos3-Edge | 20k step | 未注明 | 8.725 | 13 / 20 | 65% |
| fastwam | 30 epoch | 未注明 | 4.375 | 4 / 20 | 20% |
在这批测试中,Cosmos3-Edge 的平均得分和满分比例均为最高,平均分比 pi0 50k / FP32 高约 2.1 分。pi0 的 100k 配置也没有超过其 50k 配置,说明更长训练未必对应更好的实机表现;这不直接决定 Cosmos3 的最佳停止步数。各组训练步数、精度和部署配置不同,比较结果反映的是本次测试中的表现。
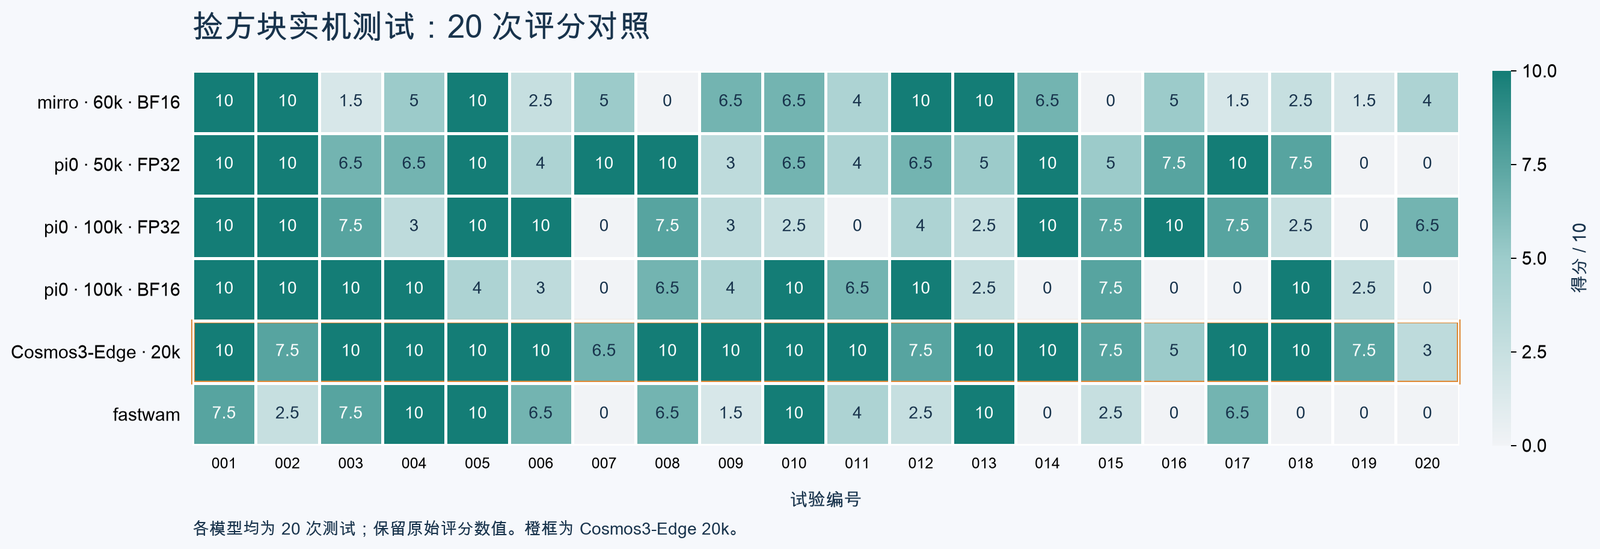
各行对应同一组 001—020 摆放编号。原表包含 1.5、3、4、6.5 等非 2.5 分档的数值,此处沿用原始评分。完整数据见 全部模型逐次评分 CSV。
Cosmos3-Edge 的低分集中在少数摆放,007、016、020 分别为 6.5、5、3 分,值得优先回看。其 13 次满分对应 65% 满分比例;平均分 8.725 / 10 不应直接换算成任务成功率。
这批 20 段实机录像均为 1280×720、15 FPS,总时长约 35 分 55 秒。下面先放一段满分试验(trial 001)的实机录像,再给出全部录像的取帧总览。
Cosmos3-Edge 20k,捡方块 trial 001(满分 10/10),约 62 秒。
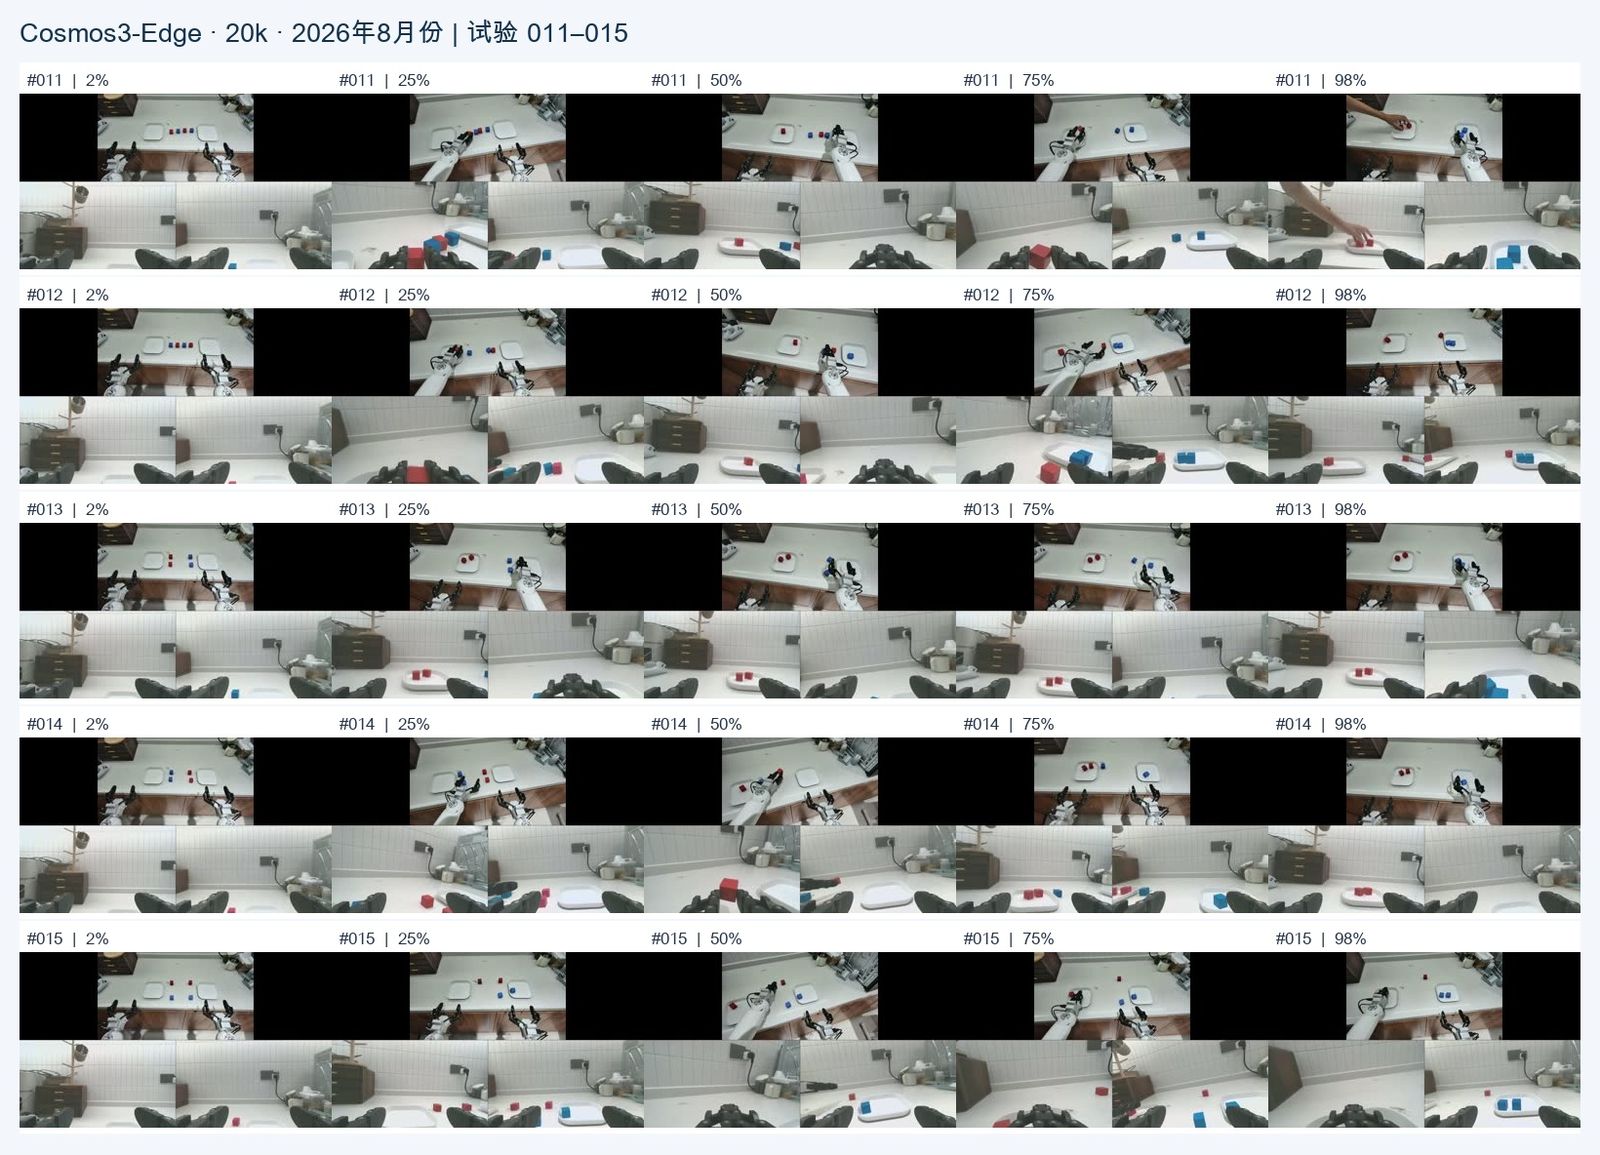
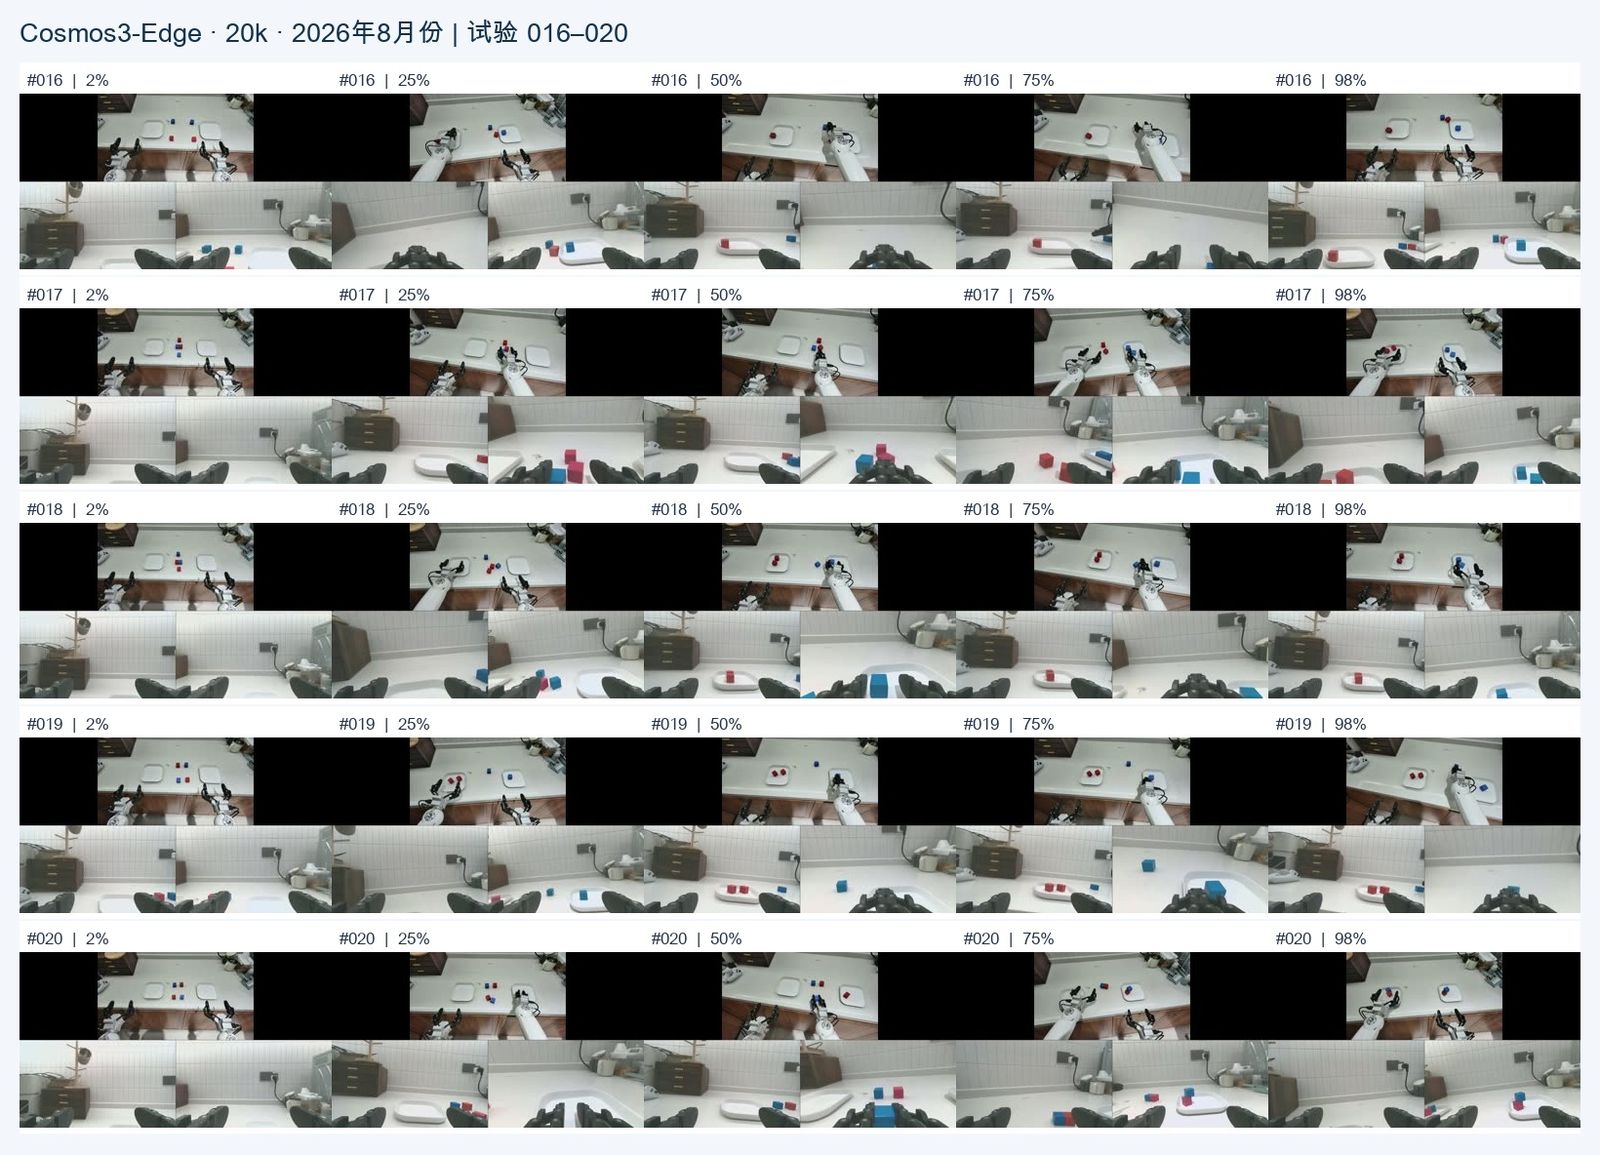
以下总览覆盖前 10 段录像,按 2%、25%、50%、75%、98% 的进度取帧,仅展示相机画面。
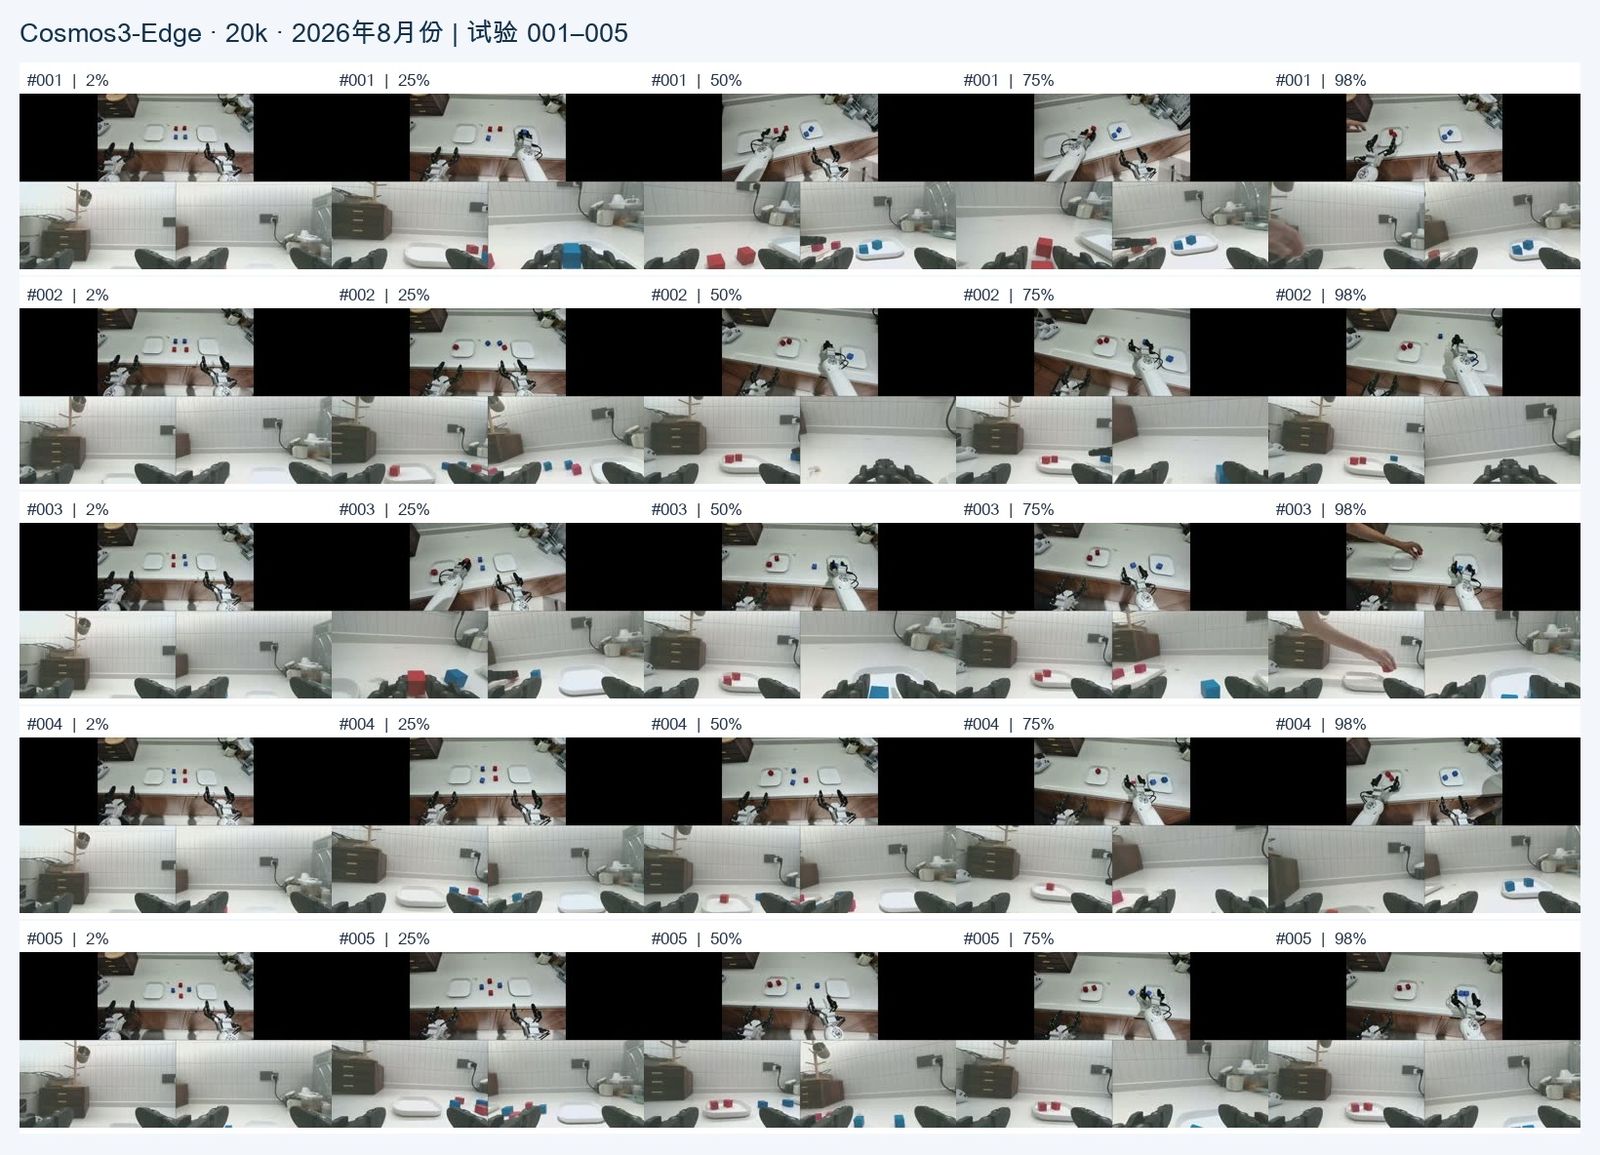
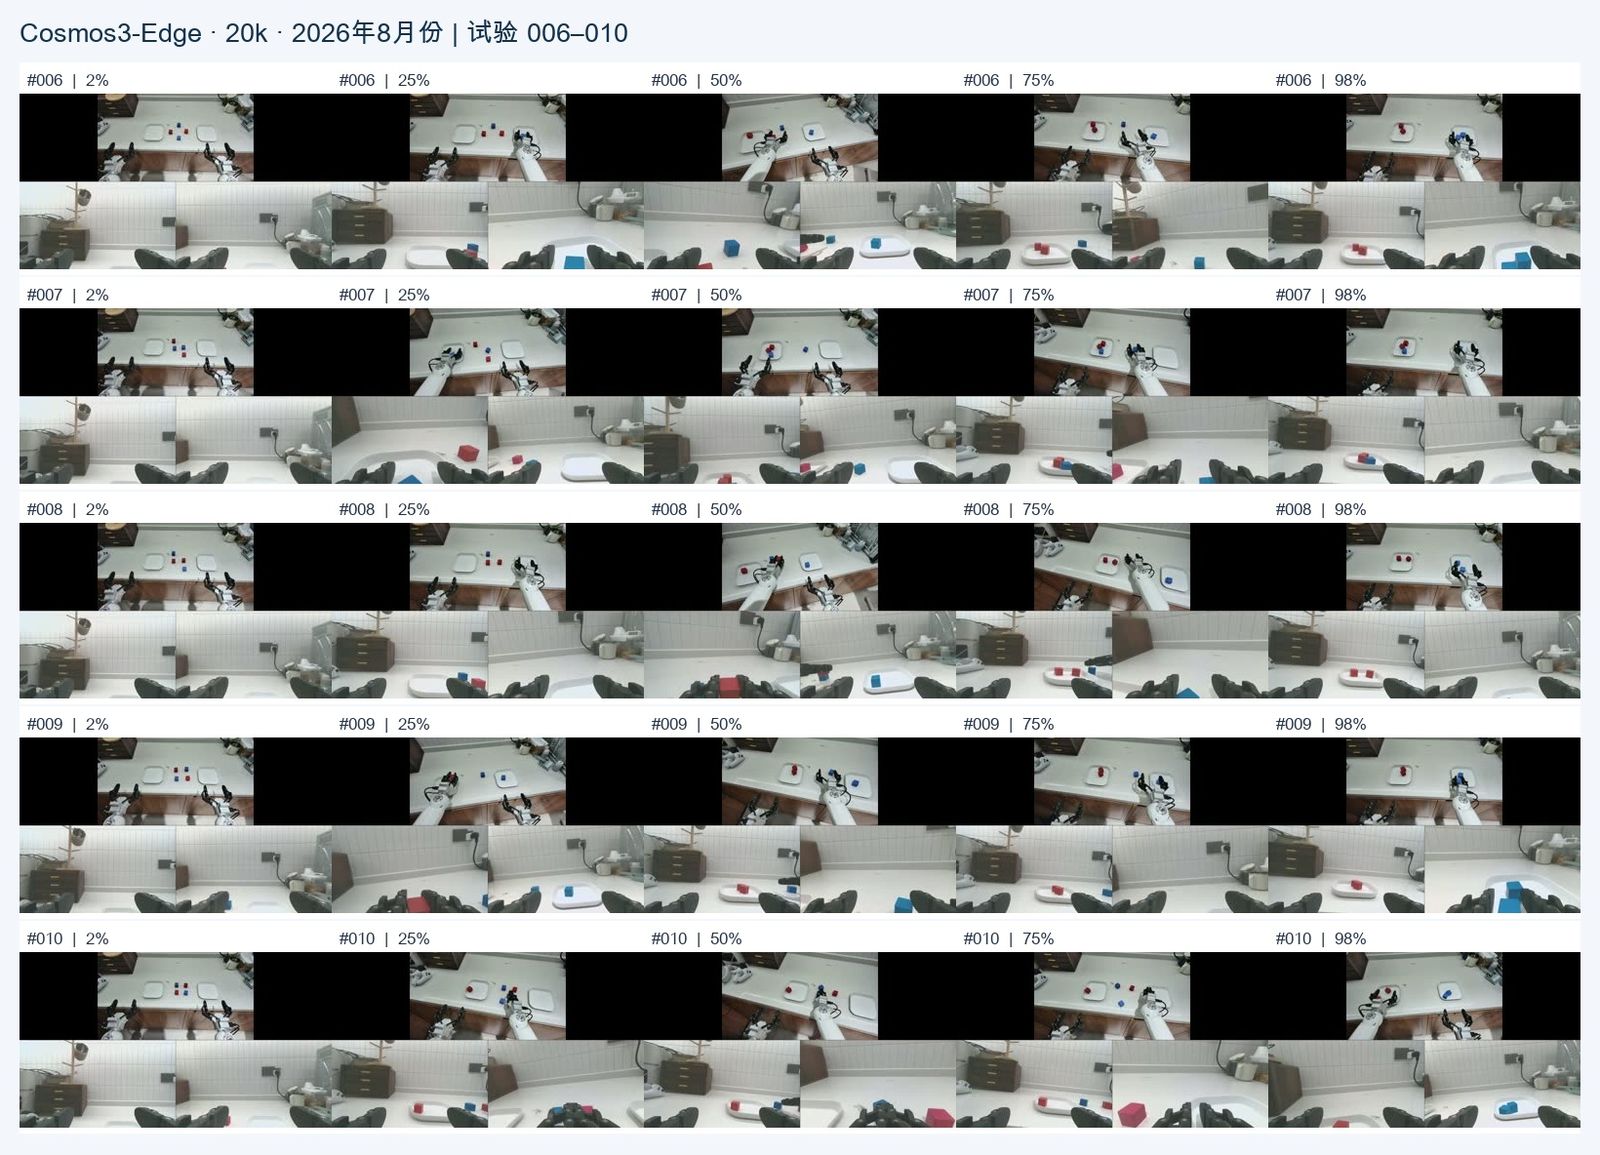
画面中可看到抓取和分盘过程,也有混放、未全部归位等现象。后续应结合评分回看低分试验,区分颜色对应错误、抓取失败、重复尝试和等待时间。录像长度包含启动或重置,不能直接作为成功耗时。
完整内容见下方 011—020 总览。
7. 反思与下一步
首先,数据适配比想象中更影响结果。 三相机布局、状态与动作时序、25 维通道定义、归一化,任何一个环节偏差都会传到最终控制。后续更换数据或任务时,应先沿着单个 episode 检查输入、标签、模型输出和反归一化结果,再投入长时间训练。
其次,应该更早开始评测,而不是默认训练到 20k。 Edge 的动作 loss 在前几千步下降最快,后期仍有改善;训练曲线无法直接给出最佳停止点。后续应把分项 loss 与固定场景的实机表现对应起来,判断继续训练是否值得。
最后,部署需要同时考虑响应速度与动作质量。 Edge / 5090 的 4 步配置已经较快,但抖动会影响抓取;50 步更平滑,却让等待和观测过时成为新问题。合适的配置应在任务得分、整体耗时和动作稳定性之间取舍,而不是单独追求最快或最平滑。
接下来优先做三件事:
- 分析低分试验。 结合已有 8.7 分的平均成绩,优先回看 007、016、020,并统一非 2.5 分档的评分说明,归纳主要失败原因。
- 确定合适的训练时长。 比较 Edge 的 5k、10k、15k、20k checkpoint,在任务表现相当时优先选择训练成本更低的版本。
- 确定端侧采样配置。 在 5090 上补测 8、12、16、20 步,固定执行策略,比较抖动、任务得分和完成时间,再调整动作块衔接。
每次运行只需把模型 step、数据版本、normalizer、主要配置和对应视频关联起来。这样下次复盘时,就能直接回答“哪次改动改善了什么”,减少重新翻找命令和文件的时间。
8. 相关资料
- 原理与官方实现:NVIDIA Cosmos 总入口、Cosmos3 项目页、技术报告、Cosmos Framework、官方文档。
- 官方模型:Cosmos3-Edge。
- 训练记录:W&B run。
- 技术报告原图摘自 Figure 3、4、5、8;训练 loss 使用本次 W&B 截图。